Serwis Edukacyjny
w I-LO w Tarnowie
Do strony głównej I LO w Tarnowie

Materiały dla uczniów liceum

  Wyjście       Spis treści       Wstecz       Dalej  

obrazek

Autor artykułu: mgr Jerzy Wałaszek

©2026 mgr Jerzy Wałaszek

obrazek

Interpolacja

Szybka Transformacja Fouriera – FFT
w przygotowaniu

SPIS TREŚCI
Podrozdziały
 

Czym jest Transformacja Fouriera?

Transformacja Fouriera (ang. Fourier Transformation, FT) jest narzędziem analitycznym, które pozwala rozłożyć skomplikowane "obiekty" na proste elementy składowe. Jako przykład, wyobraź sobie, że w kuchni w naczyniu znajduje się pyszny sok. Gdy poddasz go analizie, to otrzymasz informację z czego ten sok się składa oraz w jakiej ilości zawiera swoje składniki: np. 25% borówek, 40% bananów i 35% mleka. Coś podobnego robi transformacja Fouriera z sygnałami: bierze skomplikowany sygnał, np. dźwięk z mikrofonu, i rozbija go na pojedyncze fale sinusoidalne, z których ten dźwięk jest złożony:
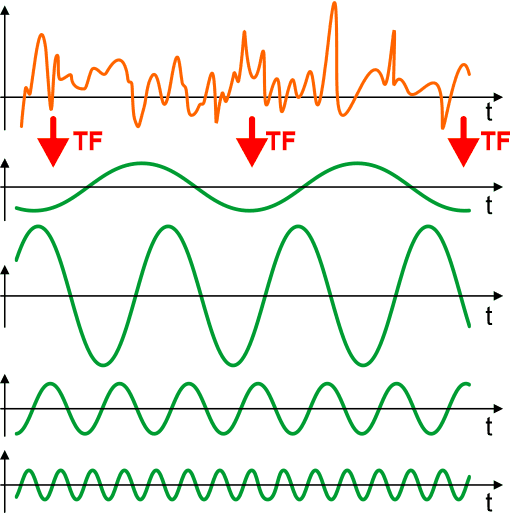
Mówiąc językiem fizyki i matematyki: FT to narzędzie, które bierze skomplikowany, „poszarpany” sygnał (np. dźwięk) i rozbija go na pojedyncze fale sinusoidalne, z których ten sygnał został złożony. Przenosi nas z dziedziny czasu \(t\) (gdzie widzimy tylko sumaryczny hałas) do dziedziny częstotliwości \(f\) (gdzie widzimy konkretne nuty/składniki):
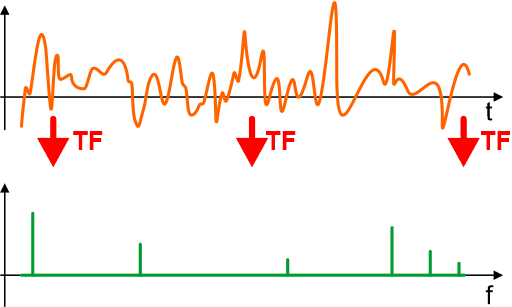
W dziedzinie czasu \(t\) (na zwykłym wykresie fali dźwiękowej) sygnały są nieczytelne. Jeśli w tym samym momencie gra gitara, perkusja i ktoś krzyczy, mikrofon rejestruje jedną, chaotyczną, falującą linię.

FT rozwiązuje problem izolacji i analizy danych:

Transformacja Fouriera zyskała na znaczeniu po opracowaniu szybkiego algorytmu dokonującego tej transformacji, tzw. FFT (ang. Fast Fourier Transformation). Tym zajmiemy się w dalszej części rozdziału. Transformację Fouriera będziemy oznaczać skrótem FT.


do podrozdziału  do strony 

Historia FT

1805 rok – Carl Friedrich Gauss (Pierwszy, ukryty algorytm FFT)

Wielu uważa, że szybki algorytm obliczania transformacji Fouriera (FFT) powstał w latach 60. XX wieku. W rzeczywistości Carl Friedrich Gauss obliczył go jako pierwszy w 1805 roku, próbując wyznaczyć orbity asteroid Pallas i Juno.

1807 rok – Jean Baptiste Joseph Fourier (Narodziny idei)

Francuski matematyk Joseph Fourier przedstawia przed Instytutem Francuskim swoją przełomową pracę dotyczącą rozchodzenia się ciepła w ciałach stałych.

1822 rok – Publikacja „Analitycznej teorii ciepła”

Po 15 latach walki z recenzentami i dopracowywania teorii, Fourier publikuje swoje opus magnum: Théorie analytique de la chaleur.

1829 rok – Peter Gustav Lejeune Dirichlet (Rygor matematyczny)

Fourier działał intuicyjnie, co dawało pole do krytyki. Niemiecki matematyk Dirichlet jako pierwszy podaje ścisły dowód matematyczny zbieżności szeregów Fouriera.

1965 rok – James Cooley i John Tukey (Ponowne odkrycie FFT i cyfrowa rewolucja)

Wraz z pojawieniem się pierwszych komputerów, klasyczna Dyskretna Transformacja Fouriera (DFT) okazała się zbyt ciężka obliczeniowo – dla \(N\) próbek wymagała \(N^{2}\) operacji.

Dopiero po publikacji odkryto, że powtórzyli oni schemat Gaussa z 1805 roku.

Przełom XX/XXI wieku – Powstanie wersji okienkowej (STFT) i falkowej

Klasyczna FT ma jedną wadę: pokazuje jakie częstotliwości są w sygnale, ale nie pokazuje, kiedy wystąpiły. W odpowiedzi na to ograniczenie matematycy rozwinęli transformację:


do podrozdziału  do strony 

Aparat matematyczny FT

Intuicja geometryczna: Szukanie przepisu

Wyobraźmy sobie, że mamy gotowe ciasto. Transformacja Fouriera to algorytm, który działa jak wykrywacz składników – mówi nam dokładnie, ile gramów mąki, cukru i jajek użyto do wypieku tego ciasta.

W świecie inżynierii i kodu dostajemy poszarpany, trudny do zanalizowania wykres funkcji w dziedzinie czasu \(f(t)\). Transformacja Fouriera przekształca go na wykres częstotliwości \(F(\omega)\), dając jasną informację: „Ten sygnał składa się w 70% z fali o częstotliwości 50 Hz i w 30% z szumu o częstotliwości 120 Hz”.

Jak zmierzyć ukrytą częstotliwość? (Mnożenie i sumowanie)

Aby sprawdzić, czy w nieznanym sygnale ukrywa się fala o konkretnej częstotliwości (np. 100 Hz), matematyka wykonuje prosty test dopasowania:

  1. Bierzemy nasz sygnał i mnożymy go punkt po punkcie przez idealną, czystą sinusoidę o częstotliwości 100 Hz.
  2. Sumujemy (całkujemy) wynik tego mnożenia z całego przedziału czasu.

Co z tego wynika?

Skrót inżynierski: Wzór Eulera

Zamiast mnożyć sygnał osobno przez sinusy (odpowiedzialne za przesunięcie w fazie) i kosinusy (odpowiedzialne za amplitudę), matematycy używają liczb urojonych. Słynny wzór Eulera wiąże funkcje trygonometryczne z funkcją wykładniczą:

\[
e^{i\varphi }=\cos \varphi +i\sin \varphi
\]

Zapis \(e^{-i\omega t}\) w transformacji Fouriera nie powinien przerażać. W interpretacji geometrycznej to po prostu "wskazówka zegara", która kręci się po okręgu płaszczyzny zespolonej w lewą stronę z określoną prędkością (częstotliwością kołową) \(\omega \).

Klasyczny wzór krok po kroku

Oto pełne, ciągłe równanie transformacji Fouriera:

\[
F(\omega )=\int \limits_{-\infty }^{\infty }f(t)\cdot e^{-i\omega t}\,dt
\]

Rozbijmy je na czynniki pierwsze:

W świecie cyfrowym (np. przy obróbce dźwięku w formacie MP3 lub filtrowaniu obrazu) całkę zastępuje się zwykłą pętlą for, która sumuje dyskretne próbki – jest to tzw. Dyskretna Transformacja Fouriera (DFT), najczęściej optymalizowana algorytmem FFT.

Wartość \(\omega \) (czyli badaną częstotliwość) bierzemy bezpośrednio z sufitu – to my, jako programiści lub badacze, decydujemy, jaką częstotliwość chcemy w danym momencie sprawdzić.

Transformacja Fouriera działa jak "radiowy odbiornik analogowy" z pokrętłem strojenia. Sygnał \(f(t)\) to całe pasmo elektromagnetyczne docierające do anteny. My kręcimy pokrętłem i ustawiamy je na konkretną wartość \(\omega \) (np. 100 MHz), aby sprawdzić, czy na tej fali nadaje jakaś stacja.

Z punktu widzenia kodu i algorytmu sprawa wygląda następująco:

W wersji ciągłej (Teoria matematyczna)

Matematyczna całka sprawdza po kolei wszystkie możliwe częstotliwości od minus do plus nieskończoności. Tworzy z tego nową, ciągłą funkcję \(F(\omega)\), gdzie osią poziomą wykresu staje się częstotliwość \(\omega\).

W wersji cyfrowej / kodzie (Praktyka programistyczna)

Gdy mamy ponumerowane próbki sygnału (np. tablicę wartości kolejnych próbek), nie możemy sprawdzić nieskończonej liczby częstotliwości. Wtedy \(\omega \) generuje się automatycznie w pętli for.

Jeśli mamy \(N\) próbek sygnału, to sprawdzamy dokładnie \(N\) różnych częstotliwości, krok po kroku:

Mówiąc krótko: \(\omega\) to parametr wejściowy pętli. Pętla zewnętrzna wybiera kolejną częstotliwość testową \(\omega \), a pętla wewnętrzna „nawija” na nią cały sygnał czasu, żeby sprawdzić, co z tego wyjdzie.

Inżynierski problem z wydajnością: Koszt \(O(N^2)\)

Ponieważ dla każdej z \(N\) częstotliwości badamy \(N\) próbek, procesor komputera musi wykonać \({N\cdot N=N^2}\) operacji mnożenia i dodawania.

Jak to oszukano? Szybka Transformacja Fouriera (FFT)

Aby uniknąć tego potężnego \(N^{2}\) sprawdzania, w latach 60. XX wieku matematycy Cooley i Tukey wymyślili genialny algorytm FFT (ang. Fast Fourier Transform).
Wykorzystuje on fakt, że "wskazówka zegara" w ułamkach zespolonych kręci się w kółko i jej wartości cyklicznie się powtarzają. Algorytm FFT dzieli całą tablicę \(N\) próbek na pół (na próbki parzyste i nieparzyste), przelicza je osobno, a potem sprytnie składa wyniki.

Dzięki temu zamiast sprawdzać wszystko \({N\cdot N}\) razy, liczba operacji spada do \({N\cdot\log_2 N}\).

Dla wspomnianego miliona próbek zamiast biliona operacji, FFT wykonuje ich tylko około 20 milionów – to dlatego np. telefon potrafi w ułamku sekundy narysować skaczące słupki korektora graficznego podczas odtwarzania muzyki.


do podrozdziału  do strony 

Algorytm FFT

Algorytm Szybkiej Transformacji Fouriera (FFT), najczęściej w klasycznej wersji Coleya-Tukeya, dzieli złożony problem na mniejsze podproblemy, wykorzystując symetrię i okresowość funkcji sinus i cosinus. Składa się on z następujących kroków głównych:

  1. Sprawdzenie i przygotowanie długości sygnału (ang. Padding):
    • Dopełnienie sygnału wejściowego zerami (ang. zero-padding) do najbliższej potęgi dwójki (\({N = 2^m}\)), ponieważ klasyczny algorytm wymaga parzystego, potęgowego podziału danych.
  2. Permutacja bitowa (ang. Bit-Reversal Permutation)
    • Zmiana kolejności elementów wejściowych na podstawie odwrócenia bitów ich indeksów (np. indeks 001 zamienia się na 100). Krok ten porządkuje dane tak, aby po wielokrotnym podziale na części parzyste i nieparzyste trafiły na właściwe miejsca.
  3. Podział rekurencyjny (ang. Divide and conquire)
    • Logiczny podział ciągu danych na coraz mniejsze podciągi (aż do par jednoelementowych). W praktyce realizuje się to iteracyjnie w postaci \({V = \log_2 N}\) etapów (motylków).
  4. Obliczenie współczynników obrotu (ang. Twiddle Factors)
    • Wyznaczenie wartości zespolonych wykładników \({(W_N^k = e^{-j\frac{2\pi k}{N}})}\), które służą do przesunięcia fazowego sygnałów na poszczególnych etapach łączenia.
  5. Kombinacja motylkowa (ang. Butterfly Computation)
    • Rdzeń algorytmu realizowany na każdym etapie: pobranie dwóch wartości, pomnożenie jednej z nich przez odpowiedni współczynnik obrotu, a następnie jednoczesne obliczenie ich sumy oraz różnicy.
  6. Agregacja (Składanie wyników)
    • Stopniowe łączenie mniejszych transformat w coraz większe, aż do uzyskania ostatecznego widma częstotliwościowego dla całego ciągu \(N\)-elementowego.

Teraz rozbijemy każdy z tych kroków na operacje podstawowe. Algorytm FFT jest dosyć skomplikowany, dlatego zastosujemy głównie opisy słowne.

Krok 1: Sprawdzenie i przygotowanie długości sygnału.

  1. Pobranie długości sygnału wejściowego (\(N_{in}\))
    • Zliczenie liczby próbek dostarczonego sygnału wejściowego.
  2. Test potęgi dwójki (Sprawdzenie warunku)
    • Sprawdzenie, czy aktualna długość \(N_{in}\) jest dokładnie potęgą dwójki (czyli spełnia równanie \({N_{in} = 2^m}\), gdzie \(m\) to liczba całkowita).
    • W praktyce programistycznej realizuje się to szybką operacją bitową: \({(N_{in}\;\&\;(N_{in}-1))=0}\).
  3. Wyznaczenie docelowej długości \({(N_{target})}\)
    • Jeżeli test dał wynik pozytywny: Długość docelowa pozostaje bez zmian \({(N_{target}=N_{in})}\). Algorytm przechodzi bezpośrednio do Kroku 2.
    • Jeżeli test dał wynik negatywny: Obliczenie najmniejszej potęgi dwójki, która jest większa niż \(N_{in}\) (np. dla sygnału o długości \(100\) próbek, docelową długością będzie \(128\)).
  4. Alokacja pamięci dla nowego bufora
    • Utworzenie nowej tablicy (lub rozszerzenie istniejącej struktury danych) o rozmiarze dokładnie \(N_{target}\) elementów.
  5. Kopiowanie danych źródłowych
    • Przepisanie wszystkich \(N_{in}\) próbek oryginalnego sygnału na początek nowego bufora danych (od indeksu \(0\) do \({N_{in}-1}\)).
  6. Dopełnienie zerami (ang. Zero-Padding)
    • Wypełnienie pozostałych, wolnych komórek pamięci w nowym buforze (od indeksu \(N_{in}\) do \({N_{target}-1}\)) wartościami zero.
  7. Przekazanie zmodyfikowanego sygnału dalej
    • Ustawienie nowego wskaźnika długości sygnału \({(N=N_{target})}\) i przekazanie przygotowanej tablicy danych do Kroku 2 (do permutacji bitowej).

Krok 2: Permutacja bitowa

  1. Wyznaczenie liczby bitów (\(m\))
    • Obliczenie, na ilu bitach muszą być zapisane indeksy tablicy, na podstawie jej długości \({N=2^m}\) (np. dla \({N=8}\) potrzebujemy \({m=3}\) bitów, ponieważ \({2^3=8}\)).
  2. Inicjalizacja pętli głównej
    • Uruchomienie iteracji po kolei przez wszystkie indeksy tablicy od \({i=0}\) do \({N-1}\).
  3. Pobranie i odwrócenie reprezentacji binarnej indeksu
    • Wzięcie bieżącego indeksu \(i\) w postaci binarnej o długości \(m\) bitów.
    • Odwrócenie kolejności tych bitów (bit najmniej znaczący staje się najbardziej znaczącym itd.), co daje nową wartość binarną reprezentującą indeks docelowy \(j\).
    • Przykład: Dla \({N=8}\) (\({m=3}\)), gdy \({i=1}\) (binarnie 001), po odwróceniu otrzymujemy 100, czyli \({j=4}\).
  4. Zabezpieczenie przed podwójną zamianą (Warunek \(i<j\))
    • Sprawdzenie, czy bieżący indeks \(i\) jest mniejszy od wyznaczonego indeksu \(j\).
    • Warunek ten zapobiega sytuacji, w której te same elementy zostałyby zamienione miejscami dwukrotnie (co przywróciłoby je do stanu początkowego)
  5. Zamiana elementów miejscami (ang. Swap)
    • Jeśli warunek \({i<j}\) jest spełniony: Zamiana wartości leżącej w tablicy pod indeksem \(i\) z wartością leżącą pod indeksem \(j\).
    • Jeśli warunek nie jest spełniony: Pominięcie zamiany i przejście do kolejnego kroku pętli.
  6. Inkrementacja i powtórzenie
    • Przejście do kolejnego indeksu \({(i\leftarrow i+1)}\) i powtarzanie operacji 3...5 aż do sprawdzenia całej tablicy.
  7. Przekazanie przeorganizowanej tablicy dalej
    • Zakończenie pętli i przekazanie tablicy (która ma teraz całkowicie zmienioną kolejność próbek, przygotowaną pod schemat motylkowy) do Kroku 3.

Krok 3: Podział rekurencyjny / Struktura etapów

W implementacjach nie-rekurencyjnych (iteracyjnych) krok ten polega na precyzyjnym skonstruowaniu trzech zagnieżdżonych pętli, które logicznie dzielą dane i sterują przechodzeniem przez kolejne etapy algorytmu:

  1. Obliczenie liczby etapów (\(S\))
    • Wyznaczenie liczby wszystkich poziomów (faz) obliczeniowych na podstawie długości sygnału: \({S\leftarrow\log_2 N}\).
  2. Inicjalizacja pętli zewnętrznej (Pętla etapów)
    • Uruchomienie pętli sterującej aktualnym etapem obliczeń (\({stage=1}\) do \(S\)). Każdy kolejny etap przetwarza dwa razy większe podgrupy danych niż poprzedni.
  3. Wyznaczenie parametrów bloku dla bieżącego etapu
    • Obliczenie rozmiaru aktualnego podproblemu/podgrupy danych: \({length\leftarrow2^{stage}}\).
    • Obliczenie rozmiaru połowy tego bloku (czyli dystansu między sparowanymi elementami w strukturze motylkowej): \({half\leftarrow\frac{length}{2}}\).
  4. Inicjalizacja pętli środkowej (Pętla bloków)
    • Uruchomienie pętli, która przeskakuje o dystans równy \(length\) przez całą tablicę danych (od indeksu \(0\) do \({N-1}\)). Krok ten rozróżnia poszczególne, niezależne podciągi na danym etapie.
  5. Inicjalizacja pętli wewnętrznej (Pętla motylków wewnątrz bloku)
    • Uruchomienie pętli indeksującej poszczególne elementy wewnątrz jednego bloku (od \(k = 0\) do \({half-1}\)).
  6. Wyznaczenie par indeksów do obliczeń
    • Dla każdej iteracji pętli wewnętrznej wyliczane są dokładne adresy dwóch próbek, które wejdą do struktury motylkowej:
      • Górny element: \({idx_{top}\leftarrow block_{start}+k}\)
      • Dolny element: \({idx_{bottom}\leftarrow idx_{top}+half}\)
  7. Przekazanie struktury sterującej do obliczeń
    • Wyznaczone pary indeksów wraz z parametrami bieżącego etapu są przekazywane bezpośrednio do wykonania operacji matematycznych (czyli Kroku 4 i Kroku 5).

Krok 4: Obliczenie współczynników obrotu / Twiddle Factors

  1. Inicjalizacja pobierania parametrów struktury
    • Odczytanie bieżącego indeksu motylka (\(k\)) oraz rozmiaru aktualnego bloku \({(length\leftarrow2^{stage})}\) przekazanych z pętli wewnętrznej Kroku 3.
  2. Wyznaczenie stałej fazowej bazy (Krok kątowy)
    • Obliczenie podstawowego kąta podziału okręgu zespolonego dla bieżącego etapu: \({(\theta_0\leftarrow-\frac{2\cdot\pi}{length})}\) (dla algorytmu w przód, stąd znak minus).
  3. Obliczenie aktualnego kąta (Fazy) dla danego motylka
    • Pomnożenie kroku kątowego przez indeks bieżącego motylka: \({(\theta\leftarrow k\cdot\theta_0=-\frac{2\pi \cdot k}{length})}\).
  4. Obliczenie wartości trygonometrycznych (Część rzeczywista i urojona)
    • Wyznaczenie wartości funkcji cosinus i sinus dla obliczonego kąta \(\theta \):
      • \(cos\_part\leftarrow\cos(\theta)\)
      • \(sin\_part = \sin(\theta)\)
  5. Złożenie zespolonego współczynnika obrotu (\(W_{N}^{k}\))
    • Konstrukcja liczby zespolonej, gdzie część rzeczywista to wartość cosinusa, a urojona to wartość sinusa: \({(W\leftarrow cos\_part+j\cdot sin\_part)}\).
    • W praktyce programistycznej tworzona jest struktura/obiekt typu Complex(real, imag).
  6. Opcjonalnie: Pobranie z tablicy (Look-up Table - LUT)
    • Alternatywna operacja optymalizacyjna: Zamiast kosztownego obliczania funkcji \(\sin\) i \(\cos\) w locie, algorytm pobiera gotową, wcześniej wygenerowaną wartość zespoloną z pamięci podręcznej na podstawie wyliczonego indeksu powiązanego z \(k\) i \(stage\).
  7. Przekazanie współczynnika do obliczeń
    • Udostępnienie wyznaczonej liczby zespolonej \(W\) do Kroku 5 w celu wykonania ostatecznej kombinacji motylkowej na wskazanych próbkach.

Krok 5: Kombinacja motylkowa / Butterfly Computation

Jest to operacja matematyczna, która stanowi fundament algorytmu FFT. Wykonuje się ją w najgłębszej pętli dla każdej pary indeksów \({(idx_{top},idx_{bottom})}\) wyznaczonej w Kroku 3, przy użyciu współczynnika obrotu \((W)\) z Kroku 4:

  1. Pobranie wartości próbek z pamięci
    • Odczytanie aktualnych wartości zespolonych zapisanych w tablicy pod dwoma indeksami:
      • Wartość górna: \({A\leftarrow tablica[idx_{top}]}\)
      • Wartość dolna: \({B\leftarrow tablica[idx_{bottom}]}\)
  2. Zespolone mnożenie wartości dolnej przez współczynnik obrotu
    • Pomnożenie wartości \(B\) przez obliczony wcześniej współczynnik \(W\). Operacja ta realizuje przesunięcie fazowe dolnej próbki:
      • \(T\leftarrow B\cdot W\)
      • W pamięci komputera operacja ta wymaga wykonania 4 mnożeń i 2 dodawań liczb rzeczywistych.
  3. Obliczenie nowej wartości dla pozycji górnej (Suma)
    • Dodanie zmodyfikowanej wartości \(T\) do wartości górnej \(A\):
      • \(A_{new}\leftarrow A+T\)
  4. Obliczenie nowej wartości dla pozycji dolnej (Różnica)
    • Odjęcie zmodyfikowanej wartości \(T\) od wartości górnej \(A\):
      • \(B_{new}\leftarrow A-T\)
  5. Zapisanie nowych wartości do tablicy (Nadpisanie/In-place)
    • Umieszczenie obliczonych wartości \(A_{new}\) oraz \(B_{new}\) z powrotem w tablicy dokładnie pod ich pierwotnymi indeksami:
      • \(tablica[idx_{top}]\leftarrow A_{new}\)
      • \(tablica[idx_{bottom}]\leftarrow B_{new}\)
      • Dzięki temu, że wyniki zapisujemy w miejsce starych danych, algorytm nie potrzebuje dodatkowej pamięci (działa "w miejscu").
  6. Zgłoszenie gotowości do kolejnej iteracji
    • Zwolnienie rejestrów procesora i przekazanie sygnału do pętli wewnętrznej (Krok 3) w celu przejścia do kolejnej pary indeksów.

Krok 6: Agregacja / Składanie wyników

Ten krok w klasycznym algorytmie iteracyjnym (in-place) nie jest osobnym blokiem kodu wykonywanym na samym końcu, lecz procesem, który zachodzi płynnie i automatycznie w miarę zamykania się pętli sterujących z Kroku 3:

  1. Zamknięcie pętli wewnętrznej (Poziom motylków)
    • Sprawdzenie warunku końca pętli dla indeksu \(k\). Po przetworzeniu wszystkich motylków wewnątrz jednego bloku danych, sterowanie powraca do pętli środkowej.
  2. Przejście do kolejnego bloku (Poziom bloków)
    • Inkrementacja wskaźnika początku bloku o wartość \(length\).
    • Powtórzenie operacji dla sąsiednich podciągów danych na tym samym etapie obliczeń (czyli powrót do kroków 5 i 6 z Kroku 3 dla nowego bloku).
  3. Zakończenie przetwarzania bieżącego etapu
    • Wykrycie przez pętlę środkową, że przetworzono już całą długość tablicy \(N\) dla danego etapu.
    • W tym momencie następuje skonsolidowanie częściowych transformat – mniejsze, niezależne widma lokalne zostały połączone w jedno większe widmo o podwojonej rozdzielczości.
  4. Inkrementacja etapu i aktualizacja geometrii \({(stage\leftarrow stage+1)}\)
    • Przekazanie sterowania do pętli zewnętrznej.
    • Zwiększenie zmiennej \(stage\), co automatycznie podwaja parametry \(length\) oraz \(half\) dla kolejnej fazy obliczeń.
  5. Sprawdzenie warunku stopu algorytmu
    • Porównanie aktualnej wartości \(stage\) z maksymalną liczbą etapów \(S\):
      • Jeżeli \(stage\le S\): Powrót do Kroku 3 i rozpoczęcie nowego, szerszego etapu łączenia danych.
      • Jeżeli \(stage>S\): Wyjście z potrójnej pętli sterującej. Oznacza to, że ostatnie dwa sub-widma o długości \(\frac{N}{2}\) zostały połączone w ostateczne widmo o długości \(N\).
  6. Opcjonalna normalizacja widma
    • W zależności od implementacji (np. dla FFT w przód): Przejście jednoelementową pętlą przez całą gotową tablicę i podzielenie każdej wartości zespolonej przez całkowitą liczbę próbek \(N\) (lub \(\sqrt{N}\)), aby zachować odpowiednie amplitudy sygnału.
  7. Zwrócenie końcowego wyniku
    • Przekazanie wskaźnika do gotowej tablicy z pełnym widmem częstotliwościowym (w dziedzinie częstotliwości) jako ostatecznego rezultatu działania algorytmu FFT.

do podrozdziału  do strony 

Przykładowa implementacja

xxx


do podrozdziału  do strony 

Zespół Przedmiotowy
Chemii-Fizyki-Informatyki

w I Liceum Ogólnokształcącym
im. Kazimierza Brodzińskiego
w Tarnowie
ul. Piłsudskiego 4
©2026 mgr Jerzy Wałaszek

Materiały tylko do użytku dydaktycznego. Ich kopiowanie i powielanie jest dozwolone pod warunkiem podania źródła oraz niepobierania za to pieniędzy.
Pytania proszę przesyłać na adres email: i-lo@eduinf.waw.pl
Serwis wykorzystuje pliki cookies. Jeśli nie chcesz ich otrzymywać, zablokuj je w swojej przeglądarce.
Informacje dodatkowe.