|
Serwis Edukacyjny Nauczycieli w I-LO w Tarnowie 
|
Autor artykułu: mgr Jerzy Wałaszek |
©2026 mgr Jerzy Wałaszek
|
|
Serwis Edukacyjny Nauczycieli w I-LO w Tarnowie
|
Autor artykułu: mgr Jerzy Wałaszek |
©2026 mgr Jerzy Wałaszek
|
| SPIS TREŚCI |
Pojęcie bitu
Przesyłanie bitów
|
| Podrozdziały |
Na potrzeby tego rozdziału przyjmijmy, iż informacja jest pojęciem pierwotnym, którego nie będziemy definiowali. Ma to pewien sens, ponieważ każdy z nas posiada swoje własne rozumienie tego terminu. Zastanówmy się natomiast, jak można reprezentować, czyli przedstawiać informację.
Zatem słowa, pismo, gesty, znaki, wszystko to może służyć do reprezentowania informacji. Elementy te będziemy ogólnie nazywali symbolami. Z kolei zbiór takich symboli nazwiemy danymi - czyli dane, to symbole, które mogą reprezentować informację. Aby wydobyć informację z danych, musimy wiedzieć, w jaki sposób informacja została z tymi danymi skojarzona, powiązana. Nie jest to wcale oczywiste. Jeśli masz wątpliwości, to proponuję taki prosty eksperyment:
Czy rozumiesz o czym mówią ludzie w tej audycji? A jeśli nie, to z jakiego powodu? Oczywiście odpowiesz - bo nie znam tego języka, co w tym dziwnego. Masz rację. Nie znasz języka i nie rozumiesz. Ale przecież odbierasz dane - czyli słowa. Gdyby dane były równoważne informacji, to odczytanie jej z tych danych nikomu nie sprawiałoby żadnej trudności i nie musiałbyś uczyć się w szkole języków obcych (wszystkie języki byłyby nasze). Niestety tak nie jest. Zatem wniosek może być tylko jeden. Same dane nie są jeszcze informacją. Musimy jeszcze znać sposób przypisania danych do określonych informacji - w przypadku języka oznacza to konieczność poznania znaczenia słówek oraz gramatyki, inaczej będziesz miał poważne kłopoty ze zrozumieniem przekazu.
Daną informację można reprezentować za pomocą różnych symboli. Przykładowo pojęcie PRZYJACIEL w różnych językach to różne słówka:
| friend | – | angielski |
| Freund | – | niemiecki |
| amigo | – | hiszpański |
| ami | – | francuski |
| barát | – | węgierski |
| mellon | – | elficki z powieści Władca Pierścieni Tolkiena (czarodziej Gandalf wypowiada to słowo, aby otworzyć magiczne wejście do kopalń Morii). |
| c'khrng | – | dźwięk wydawany na widok przyjaciela przez żabopodobne stwory, żyjące w bagnistych kraterach na czwartym księżycu ósmej planety systemu Syriusza. Ich krewniacy Lekhomonty w tej samej sytuacji wysyłają błysk promieni gamma. |
Symbole są różne, lecz znaczenie takie samo (lub prawie takie samo). Istnieją oczywiście kontrprzykłady – ten sam symbol oznacza różne informacje, np. słowa wieloznaczne:
zamek (w drzwiach, w kurtce lub duży dom dla rycerza)
dziób (ptaka, samolotu, okrętu)
blok (budynek z mieszkaniami,
krążek z liną, zablokowanie ciosu w karate)
Jednakże w większości przypadków nie dochodzi do zamieszania, ponieważ właściwe znaczenie słowa wybieramy w zależności od sytuacji, w której jest ono używane. Jeśli mówimy o zamykaniu zamka na klucz, to oczywiście mamy na myśli zamek w drzwiach, a nie miejsce noclegowe dla rycerzy (chociaż te zamki też pewnie można było zamykać na klucze). Taka jednoznaczna sytuacja nazywa się kontekstem użycia danych.
Co z tego dla nas wynika? Otóż jeśli chcemy wyrażać informację w jakiejś czytelnej dla innych formie, to:
| DANE + INTERPRETACJA + KONTEKST → INFORMACJA |
Jeśli powyższe trzy punkty spełnimy, otrzymamy system reprezentacji określonych informacji za pomocą wybranych symboli – danych. Gdy to już wiemy i rozumiemy, możemy przejść do pojęcia bitu.
Postawmy się w roli pioniera komputerów. Mamy przed sobą bardzo poważne zadanie – budowę komputera, czyli maszyny liczącej, która będzie przetwarzała informację. Zanim zaczniemy montować to ogromniaste urządzenie z tysięcy podzespołów i setek kilometrów kabli, musimy określić zbiór symboli, które maszyna ma przetwarzać. Innymi słowy musimy określić zbiór danych dla maszyny oraz sposoby ich interpretacji.
Jakie symbole wybrać? Mowę? Za trudna i jak ją zapisywać wewnątrz maszyny! Pismo? Też trudne. Gesty lepiej zapomnieć. Ideałem byłby symbole najprostsze z możliwych. Dla takich symboli może znaleźlibyśmy jakieś w miarę proste sposoby ich realizacji w naszym komputerze za pomocą odpowiednich obwodów elektronicznych. Co to mogłoby być?
I w tym miejscu ktoś kiedyś dostał olśnienia – najprostszym symbolem byłby taki symbol, który mógłby występować tylko w dwóch rozróżnialnych postaciach, w dwóch formach, najlepiej przeciwnych. Dlaczego akurat w dwóch a nie w trzech. Bo dwie postacie są prostsze od trzech, jasne?!
W układzie elektronicznym taki symbol mógłby być przedstawiany przez np. dwa różne napięcia elektryczne – pierwsza postać symbolu to napięcie powiedzmy 5 V, a druga postać to napięcie 0 V. Dwa różne napięcia da się łatwo rozróżnić i projektowanie układów elektronicznych, które na takie napięcia reagują nie jest wcale takie trudne (dla inżyniera elektronika oczywiście – dla większości licealistów jest to problem typu niemożliwego). Zamiast napięcia można na przedstawiciela naszego symbolu wybrać wybrać prąd elektryczny – prąd płynie w obwodach – pierwsza postać, prąd nie płynie – druga postać. A może światło? Jest strumień świetlny – pierwsza postać, nie ma strumienia – postać druga (cały czas czekam, aż w końcu pojawią się komputery wykorzystujące, zamiast prądów i napięć, fotony. Przyjemnie byłoby zdjąć obudowę i popatrzyć sobie, jak nasz komputerek ładnie w środku sobie świeci).
W tym momencie powinieneś zapytać – no dobrze, ale po co mi to wszystko jest potrzebne?
Cały czas chodzi nam o przedstawianie informacji przy pomocy jak najprostszych symboli. Znaleźliśmy proste dane – symbole dwustanowe. Musimy teraz pokazać, iż takie symbole będą dobrze nadawały się do naszego celu, czyli pozwolą kojarzyć z nimi dowolną ilość informacji.
Aby ułatwić sobie życie, oznaczmy stany naszego symbolu cyframi \(1\) (stan wysoki – np. napięcie 5V, prąd płynie, jest światło, itp.) oraz \(0\) (stan niski – np. napięcie 0V, brak prądu, brak światła, itp.). Dlaczego akurat wybraliśmy cyfry \(1\) i \(0\)? A dlaczego nie? Są to znaki równie dobre jak każde inne (elektronicy często w tym samym charakterze wykorzystują literki H – stan wysoki i L – stan niski, co odnosi się do poziomu napięć w układzie elektronicznym), a dodatkowo, co zobaczymy w dalszych rozdziałach, cyfry \(0\) i \(1\) posiadają wiele pożytecznych dla nas zalet. Otrzymany zbiór danych zawiera teraz dwa rozróżnialne symbole:
| Zbiór danych = \(\{0,1\}\) |
Dwóm symbolom można przypisać dwa różne znaczenia, dwie informacje. Jakie? Takie, które potrzebne są nam w danym zastosowaniu. Dla przykładu wyobraźmy sobie, iż nasz system komputerowy zbiera dane od czujników pożarowych, umieszczonych w różnych punktach budynku. Czujnik pożarowy reaguje na wzrost temperatury lub dym. Jeśli temperatura osiągnie krytyczną wartość lub pojawi się dym w otaczającym czujnik powietrzu, wewnątrz zostają zwarte dwa przewody i zaczynie płynąć prąd elektryczny. Brak prądu (stan niski \(0\)) oznacza zatem normalną temperaturę w chronionym pomieszczeniu. Pojawienie się prądu (stan wysoki \(1\)) informuje nas o wysokiej temperaturze, czyli o wybuchu pożaru.
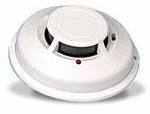
W tym kontekście stany \(0\) i \(1\) mają oczywiste znaczenie:
| \(0\) – wszystko jest w porządku, \(1\) – pożar |
W innym kontekście symbole \(0\) i \(1\) mogą posiadać zupełnie inne znaczenia (np. \(1\) – mamy czekoladę, jest dobrze; \(0\) – brakło czekolady, panika!). To od nas zależy, co im przypiszemy – o znaczeniu używanych przez ludzi słów decydowali używający je ludzie, a nie niedźwiedzie w Alpach (te być może przyczyniły się do powstania słów w stylu AUUUUU..., które są rzadkimi, wspólnymi słowami dla prawie wszystkich języków, których użytkownicy mieli okazję spotkać na swej drodze takiego niedźwiedzia. Jest to fascynujące, ale odbiega od tematu).
Symbol, który może występować w jednym z dwóch stanów (form, postaci), nazwano bitem. Twórcą tej nazwy był amerykański statystyk John Turkey, który ją wymyślił w trakcie drugiego śniadania (najprawdopodobniej po wypiciu dokładnie dwóch łyków kawy z niewielkim dodatkiem mleka, co jednakże nie miało wpływu na dalsze losy bitów) na jednej z konferencji naukowych w zimie roku 1943. W owym czasie istniały już komputery wykorzystujące opisane przez nas powyżej symbole dwustanowe do wykonywania różnych obliczeń. Informatycy oznaczali je cyframi \(0\) i \(1\), ponieważ w tej postaci nadawały się doskonale do przedstawiania liczb binarnych, dwójkowych, za pomocą których komputery wykonywały obliczenia. John Turkey utworzył nazwę bit z literek dwóch słów angielskich: binary digit (cyfra dwójkowa, czyli \(0\) lub \(1\)):
| bit = binary digit |
W późniejszym okresie John wyjawił, iż rozważał jeszcze dwie inne kombinacje literek:
| bigit
=
binary digit binit = binary digit |
Jak dzisiaj już wiemy, przyjęła się tylko pierwsza forma. Określenie bit w charakterze symbolu dwustanowego, przeznaczonego do symbolicznego reprezentowania informacji pojawiło się po raz pierwszy w 1948 roku w pracach wybitnego informatyka, Claude Shannona, twórcy teorii informacji.
Jednemu bitowi możemy przypisać maksymalnie dwie różne informacje – jedną dla stanu \(1\) oraz drugą dla stanu \(0\). Co jednak mamy zrobić, jeśli w pewnym kontekście musimy operować większą ilością informacji? Cóż, musimy potraktować bity jako literki i tworzyć z nich słowa – zupełnie tak samo jak w naszym ojczystym języku. Zbadajmy tę możliwość.
Słowo 1 bitowe0 – pierwsza informacja1 – druga informacja Słowo 2 bitowe:00 – pierwsza informacja01 – druga informacja 10 – trzecia informacja 11 – czwarta informacja Słowo 3 bitowe:000 – pierwsza informacja001 – druga informacja 010 – trzecia informacja 011 – czwarta informacja 100 – piąta informacja 101 – szósta informacja 110 – siódma informacja 111 – ósma informacja |
Nowe kombinacje słówek binarnych otrzymujemy z poprzednich kombinacji dołączając do nich raz bit o stanie \(0\), a następnie jeszcze raz dołączając bit o stanie \(1\). W efekcie ilość kombinacji zawsze podwaja się.
| 2 | 4 | 8 | 16 | 32 |
| 0 1 |
00 01 10 11 |
000 001 010 011 100 101 110 111 |
0000 0001 0010 0011 0100 0101 0110 0111 1000 1001 1010 1011 1100 1101 1110 1111 |
00000 00001 00010 00011 00100 00101 00110 00111 01000 01001 01010 01011 01100 01101 01110 01111 10000 10001 ... 11111 |
Widzimy wyraźnie, iż dodanie kolejnego bitu do słówka binarnego zwiększa dwukrotnie ilość możliwych kombinacji stanów bitów tworzących to słowo. Większa ilość kombinacji przekłada się na większą ilość informacji, które można bezpośrednio przypisać utworzonym słówkom binarnym. Ponieważ ilość kombinacji podwaja się przy każdym dodanym bicie, otrzymujemy proste zależności:
| \(1\) bit | \(\rightarrow\) | \(2\) informacje | \(\rightarrow\) | \(2^1\) informacji |
| \(2\) bity | \(\rightarrow\) | \(4\) informacje | \(\rightarrow\) | \(2^2\) informacji |
| \(3\) bity | \(\rightarrow\) | \(8\) informacji | \(\rightarrow\) | \(2^3\) informacji |
| \(4\) bity | \(\rightarrow\) | \(16\) informacji | \(\rightarrow\) | \(2^4\) informacji |
| ... | \(\rightarrow\) | ... | \(\rightarrow\) | ... |
| \(n\) bitów | \(\rightarrow\) | ... | \(\rightarrow\) | \(2^n\) informacji |
Co z tego wynika? Otóż dla każdej skończonej ilości informacji \(x\) zawsze możemy dobrać takie \(n\), aby \(n{-}\text{bitowe}\) słówka binarne przyjęły tyle różnych stanów, ile jest potrzebne do zakodowania tej ilości informacji. W tym celu wystarczy, aby był spełniony warunek:
| dla \({x>1:\;n\ge\log_2x;\;n\in\mathbb{N}}\) |
Przykład:
Załóżmy, iż w pewnym systemie informatycznym musimy przetwarzać (posługiwać się) \(1000\) różnych informacji. Przetwarzane informacje będziemy w tym systemie przedstawiać \(n{-}\text{bitowymi}\) słówkami. Ile musi wynosić \(n\), aby \(n{-}\text{bitowe}\) słówka binarne przyjęły co najmniej \(1000\) różnych kombinacji?
Odpowiedź:
\(n\ge\log_21000\approx9{,}96578\dots\), przyjmijmy zatem \({n=10}\).
Dla słówek \(10\) bitowych liczba wszystkich możliwych kombinacji wynosi \({2^{10}=1024.}\) Wynika z tego, iż w naszym systemie \(24\) słówka nie będą posiadały żadnego znaczenia – to nic, pozostaną na zapas, gdyby w przyszłości okazało się, iż zamiast \(1000\) informacji będziemy potrzebowali ich np. \(1005\).
Zapamiętaj:Słówka \(n{-}\text{bitowe}\) przyjmują \(2^n\) różnych kombinacji swoich stanów \(0\) lub \(1\). Aby przyjąć \(x\) kombinacji, słówka binarne muszą składać się z \({n\ge\log_2 x}\) bitów. |
Teraz możemy odpowiedzieć na postawione na początku rozdziału pytania:
Wszystkie algorytmy opisane w tym artykule są przedstawione w postaci listy kroków oraz implementacji w C++ (Code::Blocks) i Pythonie. Lista kroków zawsze jest poprzedzona specyfikacją algorytmu zbudowaną z następujących trzech sekcji:
Na liście kroków używamy następujących konstrukcji algorytmicznych:
Operacja przypisania. Wartość \(w\) wyrażenia zostaje umieszczona w zmiennej \(z\).
Zamiana zawartości. Po operacji \(z_1\) będzie zawierała to samo, co \(z_2\), a \(z_2\) to, co \(z_1\).
Jest to typowa instrukcja warunkowa. Jeśli warunek będzie spełniony, to zostanie wykonana operacja \(op_1\) (operacja \(op_2\) nie będzie wykonana). Jeśli warunek nie będzie spełniony, to zostanie wykonana operacja \(op_2\) (operacja \(op_1\) nie będzie wykonana). Jeśli brak członu inaczej, to algorytm przechodzi do następnego kroku. Konstrukcja ta umożliwia tworzenie rozgałęzień w algorytmie. Czasami zamiast pojedynczej operacji podajemy ich ciąg rozdzielony przecinkami. W takim przypadku operacje są wykonywane kolejno od strony lewej do prawej
Jest to konstrukcja pętli iteracyjnej. Dla kolejnych wartości zmiennej \(z\) równych \({a,b,\dots,c}\) wykonywana jest podana operacja \(op\) lub wykonywane są kroki w zakresie od Kxx do Kyy. Kroki wykonywane są kolejno od górydo dołu. Gdy pętla się zakończy wykonywany jest krok Kyy + 1 – znajdujący się za ostatnią z powtarzanych instrukcji. Dodatkowo w obrębie pętli stosujemy wcięcia, aby poprawić czytelność tej konstrukcji.
Jest to konstrukcja pętli warunkowej. Jeśli warunek jest prawdziwy, to wykonywana jest operacja \(op\) lub kolejne kroki od Kxx do Kyy. Kroki wykonywane są kolejno od góry do dołu. Po ostatnim kroku Kyy warunek jest ponownie testowany i w przypadku jego spełnienia, kroki Kxx … Kyy są wykonywane ponownie. Gdy pętla się zakończy wykonywany jest krok Kyy+1 – za ostatnią z powtarzanych instrukcji. W przypadku, gdy warunek jest nieprawdziwy przed wejściem do pętli, nie zostanie wykonany żaden krok od Kxx do Kyy – algorytm przejdzie od razu do kroku Kyy+1.
Następnym krokiem wykonywanym przez algorytm będzie krok Kxx.
Algorytm przejdzie do wykonania kolejnego obiegu pętli zdefiniowanej w kroku Kxx. Przed rozpoczęciem obiegu sprawdzane są odpowiednie warunki kontynuacji pętli:
Algorytm wyprowadza na wyjście wartość wyrażenia \(w\).
Algorytm odczytuje z wejścia dane dla podanej zmiennej \(z\) (lub dalszych zmiennych \(z_i\)). Tam, gdzie dane wejściowe są oczywiste i opisane w specyfikacji, pomijamy ich odczyt w algorytmie.
Kończy działanie algorytmu
Kończy działanie algorytmu z wynikiem \(x\) – ta postać zakończenia jest używana w algorytmach funkcji.
Niektóre operacje algorytmu muszą być opisane słownie, ponieważ ich wykonanie zależy od specyfiki używanego języka programowania lub też wymaga wielu operacji prostych.
W wyrażeniach stosujemy następujące operatory:
| \(+-\cdot:\dfrac{a}{b}\) | - | podstawowe operacje arytmetyczne |
| \(\times\) | - | mnożenie macierzy |
| \(\sqrt{w}\) | - | pierwiastek kwadratowy z \(w\) |
| \(\bmod\) | - | reszta z dzielenia całkowitoliczbowego |
| \(\text{div}\) | - | dzielenie całkowite |
| \(\lor\) | - | operacja logiczna alternatywy |
| \(\wedge\) | - | operacja logiczna koniunkcji |
| \(\oplus\) | - | operacja logiczna sumy symetrycznej |
| \(\neg\) | - | operacja logiczna negacji |
| \(\&\) | - | bitowa operacja koniunkcji |
| \(\mid\) | - | bitowa operacja alternatywy |
| \(\sim\) | - | bitowa operacja negacji |
| \(^\wedge\) | - | bitowa operacja sumy modulo 2 |
| \(\gg\) | - | przesunięcie bitowe w prawo |
| \(\ll\) | - | przesunięcie bitowe w lewo |
| \(|w|\) | - | wartość bezwzględna z \(w\) |
| \([w]\) | - | część całkowita z \(w\) |
| \(\lfloor w\rfloor\) | - | zaokrąglenie \(w\) w dół do najbliższej liczby całkowitej |
| \(\lceil w\rceil\) | - | zaokrąglenie \(w\) w górę do najbliższej liczby całkowitej |
| \(< \le = \ne \ge >\) | - | operatory porównań |
| \(\rightarrow\) | - | wskazanie pola struktury |
| \(.\) | - | odwołanie do pola struktury |
W artykule używane są niekiedy programy w językach C++ (Code::Blocks) i Python (Visual Studio Code, PyCharm lub IDLE) do ilustracji lub wspomagania omawianych zagadnień. Listingi zostały przystosowane do przeglądania na smartfonach, dlatego mają wąską szerokość, co nie wpływa na działanie samych programów.
Zapraszam
do lektury
mgr Jerzy Wałaszek
 |
| Zespół Przedmiotowy Chemii-Fizyki-Informatyki w I Liceum Ogólnokształcącym im. Kazimierza Brodzińskiego w Tarnowie ul. Piłsudskiego 4 ©2026 mgr Jerzy Wałaszek |
Materiały tylko do użytku dydaktycznego. Ich kopiowanie i powielanie jest dozwolone pod warunkiem podania źródła oraz niepobierania za to pieniędzy.
Pytania proszę przesyłać na adres email:
Serwis wykorzystuje pliki cookies. Jeśli nie chcesz ich otrzymywać, zablokuj je w swojej przeglądarce.
Informacje dodatkowe.


